Сравнить две таблицы с помощью ИИ: учесть каждую строку
Как сравнить две таблицы с помощью ИИ по артикулу: найти изменения, отделить спорные записи и проверить, что итоговый CSV учитывает каждую исходную строку.
Чтобы сравнить две таблицы с помощью ИИ, приложите две выгрузки CSV, укажите устойчивый ключ и поля для сравнения. Попросите отдельный CSV с четырьмя статусами, список спорных записей и отчет об учете входных строк. Проверьте результат по исходникам: ответ «нашел два изменения» не показывает, какие строки прочитаны, а какие пропущены.
Разберем старый и новый прайс. Ищем добавленные, пропавшие и измененные позиции. Сравниваем значения, а не формулы или оформление книги. В реестре вместо артикула подойдет ID заказа или инвентарный номер.
Строки переставили. Товары не изменились
Если поставщик отсортировал прайс по цене, пятая строка старого файла уже не соответствует пятой строке нового. Сверка по порядку строк покажет изменения там, где их нет. Номер нужен для возврата к исходнику, а сопоставлять записи надо по артикулу или ID.
Выберите поле, которое обозначает одну запись в обеих версиях. Название товара ненадежно: «Кабель USB» могли сократить до «Кабель». Если артикул повторяется на разных складах, используйте сочетание артикула и склада. Поля ключа должны означать одно и то же.
Храните ключ как текст. Артикулы 001 и 1 различаются, пока владелец данных не подтвердил обратное. Если нули потерялись при экспорте, агент не должен восстанавливать их наугад. Не разрешайте автоматически склеивать похожие названия или выбирать одну из повторных записей.
Что именно считать изменением
В нашем прайсе проверяем цену в рублях и остаток в штуках. Название оставляем для пояснения: его изменение само по себе не меняет статус. Цены сравниваем после округления до двух знаков; для неотрицательных цен половину копейки округляем вверх. Остатки сравниваем точно. Допуск, например разница не больше копейки, будет другим правилом; его надо указать отдельно.
Сначала согласуйте валюту, единицы и учет НДС. Цена в рублях не сравнима с ценой в долларах без правила пересчета. Пробелы и десятичные разделители можно привести к одному виду для расчета, сохранив исходные значения. Подготовка одной выгрузки разобрана в статье про обработку таблиц с помощью нейросети.
Пустое значение не равно нулю. Ноль означает известное количество, пустота означает отсутствие значения. Переход от пустого остатка к 0 считаем изменением; две пустоты в одном сравниваемом поле считаем совпадением. Если число не читается, все записи этого ключа выносим на проверку.
При ручной сверке приходится искать артикулы, проверять цены и отдельно собирать позиции, которых нет во втором файле. Можно поручить сверку двух выгрузок агенту, приложив два CSV и описав правила. Запросите значения обеих версий и номера исходных записей.
Правила проверяемы и без ИИ. Power Query сопоставляет таблицы по одному или нескольким столбцам с согласованными типами; полное внешнее соединение сохраняет обе стороны. В pandas.merge есть проверка уникальности ключей и отметка происхождения записей. Пустые ключи могут сопоставляться между собой, поэтому в нашей сверке отделяем их заранее. Они контролируют соединение, но правила сравнения задаете вы.
Две выгрузки на учебном примере
В old.csv семь строк данных, в new.csv шесть. Заголовки не считаем. Номер здесь обозначает запись данных, начиная с 1, а не физическую строку текста CSV. Знак «—» в таблицах обозначает пустую ячейку; в файлах она пустая. Артикулы сохраняем текстом.
Первый файл, old.csv
| Строка | Артикул | Товар | Цена, руб. | Остаток, шт. |
|---|---|---|---|---|
| 1 | 001 | Кабель | 100,00 | 8 |
| 2 | 002 | Адаптер | 250,00 | 5 |
| 3 | 003 | Чехол | 300,00 | 2 |
| 4 | 004 | Держатель | 150,00 | — |
| 5 | 009 | Зарядка | 400,00 | 1 |
| 6 | 009 | Зарядка | 420,00 | 1 |
| 7 | — | Переходник | 90,00 | 3 |
Второй файл, new.csv
| Строка | Артикул | Товар | Цена, руб. | Остаток, шт. |
|---|---|---|---|---|
| 1 | 004 | Держатель | 150,00 | 0 |
| 2 | 001 | Кабель | 100,00 | 8 |
| 3 | 002 | Адаптер | 270,00 | 5 |
| 4 | 005 | Подставка | 200,00 | 4 |
| 5 | 009 | Зарядка | 420,00 | 1 |
| 6 | — | Переходник | 90,00 | 3 |
Артикул 009 повторяется в первом файле. В спорный список отправляем обе его записи из old.csv и единственную из new.csv: неоднозначность затрагивает обе стороны. Выбрать цену 420,00 потому, что она совпала, означало бы скрыть другую исходную запись. Правила проверки повторов внутри файла разобраны в материале про поиск дублей в таблице.
Отдельно сохраняем две записи с пустым артикулом. Их одинаковые названия и цены не доказывают, что это один товар. Каждая спорная запись остается самостоятельной, с источником, номером, исходными полями и причиной проверки.
Пять записей результата учитывают восемь входных строк
После отделения спорных записей результат выглядит так. «Нет» означает отсутствие записи в другой выгрузке, а «пусто» обозначает пустое поле существующей записи.
| Артикул | Строка old.csv | Строка new.csv | Статус | Цена: старая → новая | Остаток: старый → новый |
|---|---|---|---|---|---|
| 001 | 1 | 2 | Совпало | 100,00 → 100,00 | 8 → 8 |
| 002 | 2 | 3 | Изменилось | 250,00 → 270,00 | 5 → 5 |
| 003 | 3 | Нет | Только в первой | 300,00 → нет | 2 → нет |
| 004 | 4 | 1 | Изменилось | 150,00 → 150,00 | пусто → 0 |
| 005 | Нет | 4 | Только во второй | нет → 200,00 | нет → 4 |
Итоги: одно совпадение, два изменения, одна запись только в первой и одна только во второй. Отсутствие 003 не доказывает снятие товара с продажи; это лишь факт состава выгрузки.
Покрытие проверяем по каждому источнику. В первом файле четыре строки основной сверки плюс три спорные дают семь. Во втором четыре основные плюс две спорные дают шесть. Вместе учтены все 13 входных строк: восемь в основной сверке и пять отдельно. Три пары превратились в три записи результата, еще две записи пришли только с одной стороны.
Одного равенства сумм мало. Проверьте пары «имя файла + номер записи»: каждая должна встретиться ровно один раз либо в основном результате, либо в спорном списке. Иначе повторно учтенная строка может скрыть пропущенную.
Задание, по которому можно проверить CSV
Сохраните нужные листы как два CSV и проверьте артикулы после экспорта. Здесь не нужна прямая ссылка на Google Таблицы или передача XLSX. Приложите оба файла и адаптируйте постановку:
Сравни old.csv и new.csv по текстовому полю «Артикул», сохрани ведущие нули. Проверяй цену в рублях после округления до двух знаков, половину копейки округляй вверх. Остаток сравнивай точно. Пустота отличается от нуля; две пустоты совпадают. Порядок записей игнорируй. Исходники не меняй.
Верни comparison.csv: артикул, статус, номера записей обоих источников, старые и новые цена и остаток, измененные поля. Используй четыре статуса: «только в первой», «только во второй», «изменилось», «совпало». Отсутствующую запись отличай от пустого значения по номеру записи источника.
В disputed.csv вынеси записи с пустыми ключами. Если ключ повторяется или сравниваемое число не читается, вынеси все записи этого ключа из обоих файлов. Сохрани источник, номер записи данных без заголовка, исходные поля и причину. Не склеивай записи. CSV сохрани в UTF-8 с разделителем «;». В отчете укажи входные, основные и спорные строки отдельно для каждого файла, итоги статусов и проверку однократного учета каждой исходной записи.
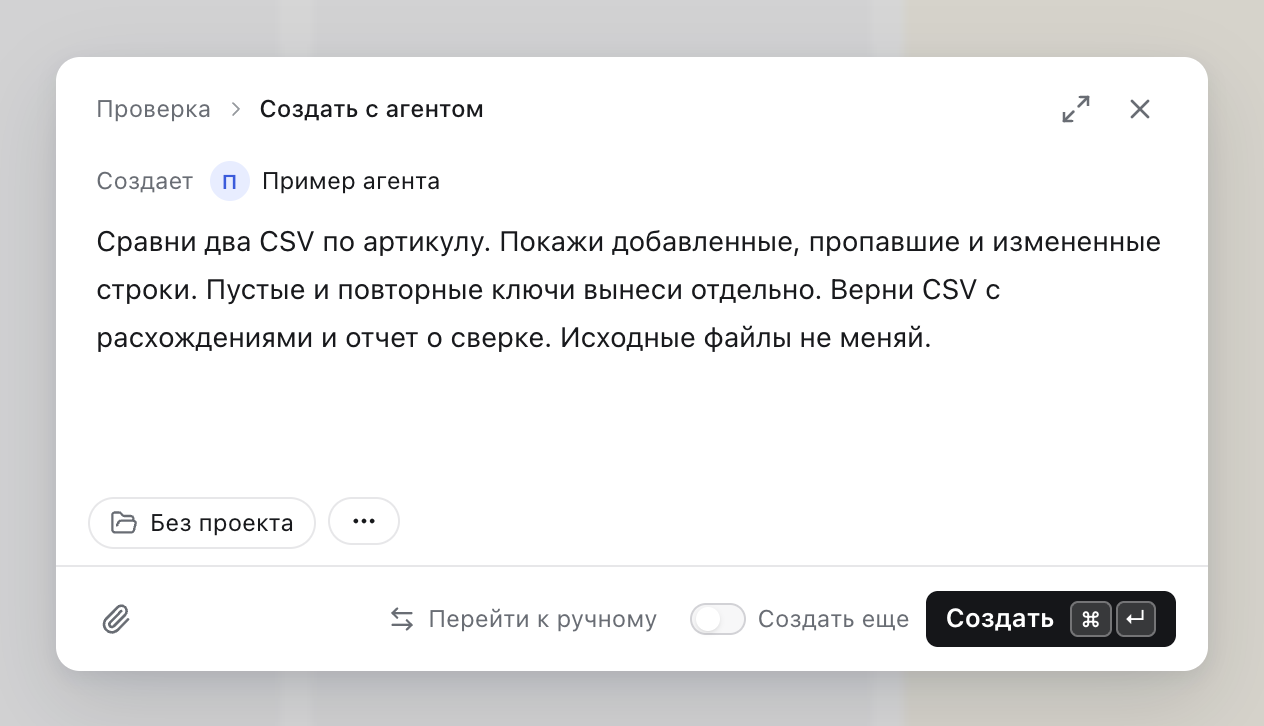
Демонстрационная область Otdano с учебной постановкой и исполнителем «Пример агента». Снимок показывает заполнение задачи, а не реальную выполненную сверку.
Чеклист приемки
- Сверьте покрытие каждого файла и однократный учет каждой исходной записи, включая спорные.
- Проверьте несколько совпадений и расхождений по исходникам. В коротком примере выше проверьте все пять записей результата.
- Откройте CSV через импорт: укажите разделитель и текстовый тип артикула, чтобы программа не убрала ведущие нули.
- Проверьте старые и новые значения в отдельных столбцах, пустоты и нули, номера источников и перечень измененных полей.
- Убедитесь, что дубли не умножили строки: все три записи артикула
009находятся только в спорном списке.
Неполное покрытие или неверная контрольная пара требуют исправления. Спорные записи разберите с владельцем данных; повторную сверку проводите после уточнения правил или исправления источников.